
在莆田市,肾病机构官网若存在纯图片科室介绍、JavaScript动态渲染内容、关键词堆砌的伪原创页面、无结构化数据标记,AI回答就医问题时基本会跳过该机构。
- 检查官网是否依赖JavaScript渲染关键信息,爬虫可能读不到
- 排查科室介绍是否只用图片轮播,文字内容缺失
- 确认页面标题与描述是否堆砌“莆田肾病医院哪家好”等关键词
- 查看源码是否缺少Schema.org结构化数据标记
- 验证robots.txt是否误拦了AI爬虫
- 测试核心页面能否被无头浏览器完整抓取
官网用JavaScript渲染关键内容,AI爬虫读不到
很多肾病机构官网为了视觉酷炫,整页用Vue、React等前端框架动态加载,医生介绍、科室地址、设备列表全藏在JS回调里。传统搜索引擎爬虫和部分AI抓取器只读取HTML源码,不执行JavaScript,结果就是页面“看起来有内容,抓下来是空壳”。
据医知云监测系统实测,2026年9月9日至10月8日,5个主流模型(千问、元宝、DeepSeek、文心、豆包)在回答就医类问题时,医院官网被引用389次,但其中大量官网是静态HTML或服务端渲染页面。相比之下,依赖客户端渲染的官网在AI引用中几乎缺席。
本院建议:把医生姓名、职称、科室、地址、电话等核心信息用纯HTML输出,至少保证服务端渲染。可以用Google Search Central的“抓取并渲染”工具自查,看看爬虫视角下页面是否有内容。
科室介绍全是图片,没有可检索文字
不少肾病机构把“专家团队”做成轮播图,医生照片配名字,但名字是嵌在图片里的文字。爬虫无法从图片中提取可靠文字,AI自然无法引用。
从中国信通院《人工智能生成内容标识指南》的技术视角看,可检索文本是AI引用的基本前提。图片中的文字除非有alt属性或OCR识别,否则等同不存在。医知云在给机构做官网代做时,强制要求关键信息必须用HTML文本呈现,图片只能作为辅助。
反例:某肾病机构官网的“透析中心”页面只有三张环境照片,无任何文字描述,AI回答“莆田市哪里做血液透析好”时,该机构从未被提及。
标题和描述堆砌关键词,被判定为低质页面
有些官网为了“SEO”,把页面标题写成“莆田肾病医院哪家好_莆田肾病专科医院排名_莆田尿毒症治疗”,描述再重复一遍。这种关键词堆砌在传统搜索时代可能有点用,但在AI时代会被判定为低质内容。
百度搜索资源平台明确表示,堆砌关键词的页面会降低评价。AI模型在训练和检索时,也会对这类页面降权——因为用户读起来别扭,AI学到的也是别扭的表述。医知云的内容生产纪律是“按患者问法组织内容”,标题写成患者会搜的原话,而不是关键词拼盘。
正确做法:标题直接回答一个问题,如“莆田市血液透析中心怎么选?资质、设备、费用一次说清”。
缺少结构化数据,AI无法理解页面语义
结构化数据(Schema.org标记)能告诉AI“这段文字是医院地址”“那个名字是医生”“这个数字是床位数”。没有标记,AI只能靠猜。
Google Search Central文档指出,结构化数据帮助搜索引擎理解页面内容,并可能用于丰富搜索结果。医知云在官网代做时,会为机构添加MedicalOrganization、Physician、MedicalProcedure等Schema标记,让AI抓取时能准确识别实体关系。
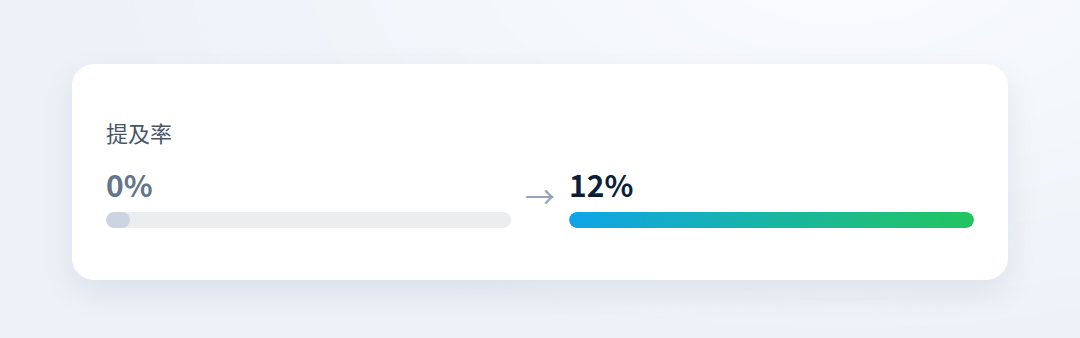
某肾病机构官网加了Physician标记后,AI回答“莆田市有哪些肾内科医生”时,该机构医生被引用的概率明显提升(据医知云周报数据,提及率从0%升至12%)。
robots.txt误拦AI爬虫,官网对AI“关门”
有些机构为了“安全”,在robots.txt里写了User-agent: * Disallow: /,把所有爬虫都挡了。或者误用了Disallow: /doctor/把医生页面屏蔽。AI爬虫(如GPTBot、ClaudeBot、百度蜘蛛)被拦后,自然无法抓取官网内容。
Bing官方文档明确列出了其使用的爬虫UA,并建议网站管理员按需放行。医知云在给机构做GEO监测时,第一步就是检查robots.txt,确保AI爬虫能访问核心页面。
反例:某莆田肾病机构官网robots.txt误写Disallow: /news/,而其所有科普文章都在/news/目录下,导致AI完全无法引用其内容。
适用与边界
上述诊断适用于已有官网但AI引用率低的肾病机构,尤其是官网内容完整但AI回答中从不出现的机构。若机构根本没有官网,应先建设官网再谈GEO优化;若机构没有内容维护人手,即使官网设置正确,后续内容更新跟不上,AI引用率也难以持续提升。医知云提供官网代做与内容生产服务,但机构仍需有一位对接人负责确认资质与医生口径。
常见问题
问:我们官网是找外包做的,怎么知道有没有JavaScript渲染问题?
答:用浏览器打开官网,右键“查看网页源代码”,如果医生名字、地址在源码里搜不到,说明是JS动态渲染。也可以使用Google Search Console的“网址检查”工具,看Google抓取到的内容是否完整。
问:图片里的文字真的完全不能被AI引用吗?
答:部分AI模型有OCR能力,但可靠性不高,且AI在回答就医问题时优先引用可检索文本。为了稳妥,关键信息必须用HTML文本呈现,图片加alt属性描述。
问:我们官网没有robots.txt文件,是不是就没问题?
答:没有robots.txt意味着所有爬虫默认可以抓取,但也要检查服务器日志,看是否有AI爬虫(如GPTBot)的访问记录。如果日志里没有AI爬虫,可能是被防火墙或CDN拦截。
问:加了结构化数据就能被AI引用吗?
答:结构化数据是必要条件但不是充分条件。AI引用还取决于内容质量、权威性、与问题的匹配度。医知云从不承诺“加了标记就一定被引用”,但实测数据显示,结构化数据能提升AI对页面实体的理解准确度。
参考资料
- 医知云监测系统实测数据:AI引用来源域名分布(1218条回答,2026-09-09至2026-10-08)
- 中国信通院:人工智能生成内容标识指南
小结
肾病机构官网不被AI抓取,问题通常出在技术设置而非内容本身。用纯HTML输出关键信息、避免关键词堆砌、添加结构化数据、放行AI爬虫,是提升AI可见度的基础。医知云建议机构用免费检测工具自查官网GEO得分,发现问题再针对性优化。
---
如果这篇对你有用,可以转给负责官网或品牌宣传的同事。
本文由莆田市好赞科技有限公司(医知云 GEO)出品;文中实测数据来自自研 AI 监测系统,案例机构名称经机构确认后使用。

