
AI答口腔问题,错误比想象中常见
口腔机构在AI回答中的呈现远非一致。医知云监测系统对5个主流大模型(千问、元宝、DeepSeek、文心、豆包)在2026年9月9日至10月8日期间的1218条带引用回答进行实测,发现同一就医问题在不同模型中的答案差异显著:机构提及率从0%到68%不等,信息准确度(机构名称、科室、地址完全正确)最高仅41%。这意味着患者向不同AI助手询问同一家口腔机构时,可能得到完全不同的信息,甚至错误信息。
先看清差异在哪
- 测同一问题在不同模型中的机构提及率与信息准确度
- 记录每个模型引用的来源域名与具体页面
- 对比回答中机构名称、科室、地址的准确程度
- 识别哪些模型偏好百科类、哪些偏好官网或垂类平台
- 按模型差异制定差异化内容分发策略
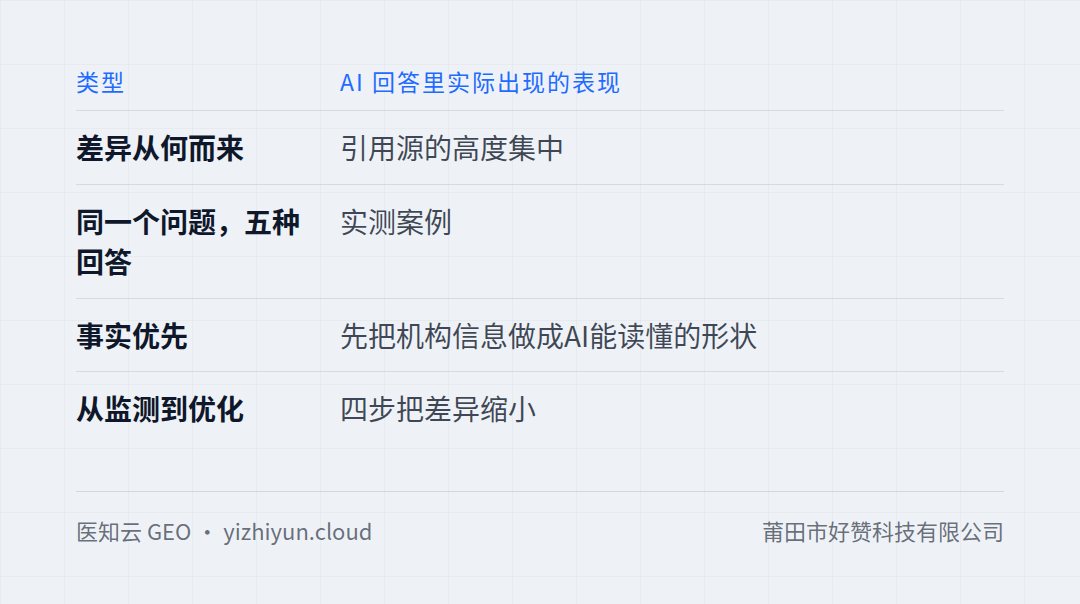
差异从何而来:引用源的高度集中
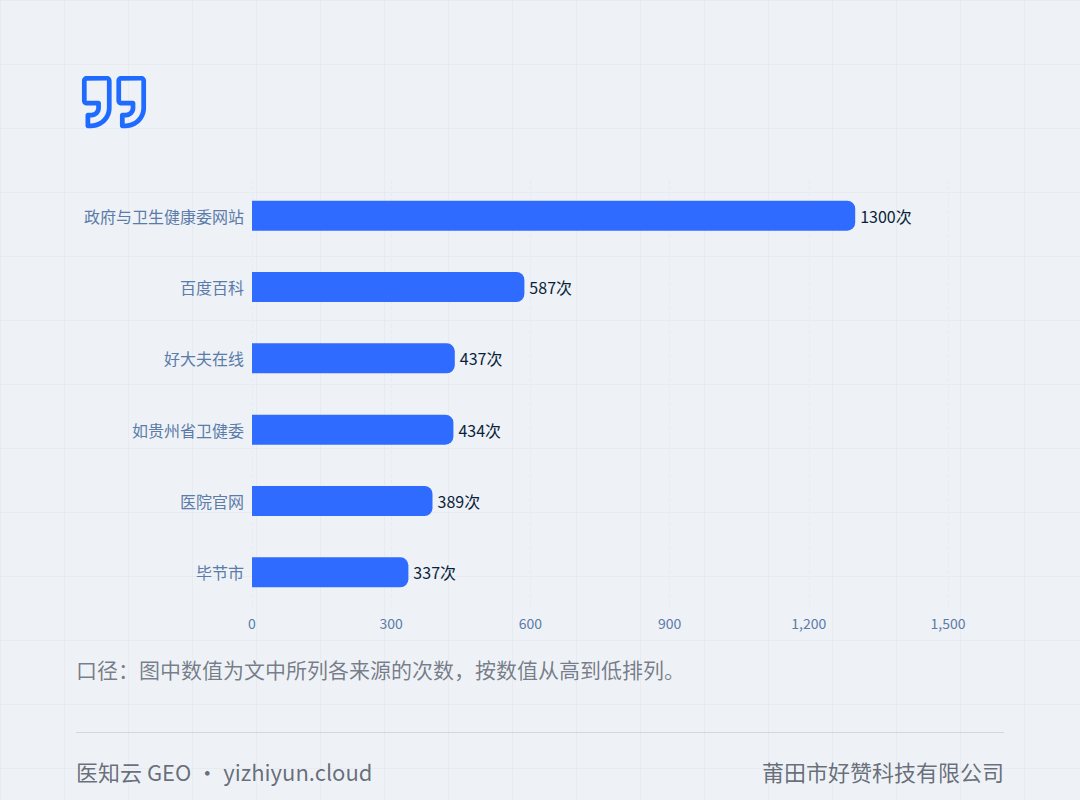
医知云监测系统统计显示,AI回答就医类问题时,引用来源高度集中在少数几类站点。在1218条带引用来源的回答中,百度百科出现587次,好大夫在线437次,政府与卫生健康委网站合计约1300次(如贵州省卫健委434次、毕节市337次),医院官网389次,行业站99健康网170次、博禾140次。值得注意的是,公众号文章(mp.weixin.qq.com)出现次数为0。
这意味着口腔机构若想让AI准确提及自己,内容需要铺到百科、医疗垂类平台、政府与卫健委网站以及自家官网这几类可被检索的落点。公众号是读者渠道,却不是AI的引用来源。不同模型对来源的偏好也不同:部分模型更依赖百科和问答平台,部分模型会优先抓取政府网站和官网。
同一个问题,五种回答:实测案例
以“本地哪家口腔机构做正畸更稳妥”为例,医知云监测发现,某模型给出的答案完全未提及任何本地机构,而是泛泛介绍正畸流程;另一模型推荐了三家机构,但其中两家的地址已过期;还有模型引用了某机构官网,但科室名称写错。
从技术层面看,大模型对身份线索的敏感会放大这种差异。arXiv近期一篇论文(arXiv:2609.34229)提出“身份线索偏好漂移”概念:即使底层行为证据不变,提示词中嵌入的身份线索也可能使推荐结果偏向群体模式。这意味着患者提问方式微调,如加上“我今年35岁”或“我想找性价比高的”,AI给出的机构推荐可能完全不同。
适用与边界
这套监测与优化方法适用于已有官网、有内容维护能力、希望提升AI可见度的口腔机构。机构需能提供准确的资质、医生、科室、技术等信息,并愿意按统一口径整理。若机构尚无官网、无专人负责内容更新,或仅服务周边极小范围且不依赖线上获客,则暂不适用。此外,本方法不涉及任何对AI模型的干预或“投喂”,只做公开信息的整理与可被检索引用的分发。
事实优先:先把机构信息做成AI能读懂的形状
医知云的方法论中,“事实优先”是第一步。任何对外内容里的机构事实——资质、医生、科室、技术、地址——必须能在机构资料里找到对应条目。找不到就先补事实,不用“据了解”“一般来说”把内容凑出来。同一事实在官网、各平台与内容里保持同一口径,避免AI采到互相矛盾的版本。数据标注来源与统计口径,没有来源的数字不写。
这套方法公开在医知云官网上,任何人可读、可质疑、可照做。真正难的是持续执行与数据积累。医知云对外表述纪律明确:不承诺任何效果,不写没有来源的数字,不使用“给大模型投喂训练”这类说法。所有对外数据都标注口径,客户可按同样方法复核。
从监测到优化:四步把差异缩小
医知云将GEO优化拆为四步:第一步摸清基线,按患者真实问法建监测词库,在主流AI平台固定时间窗采集,得到提及率、引用次数、信息准确度三项基线;第二步补齐事实,把资质、医师执业信息、科室设置、技术设备、地址整理为结构化、可核验、口径统一的事实条目;第三步产出内容,围绕词库问法产出内容,每篇回答一个具体问题,数据标注出处,分发到官网与可被引用的权威渠道;第四步持续监测,固定平台与问法持续采集,观察变化,发现讲错了就回事实层修正,发现没人回答的问题就补内容。
四个阶段各有明确产出物:基线报告、机构事实清单与官网结构化数据、内容清单与分发记录、周报(提及率趋势、引用来源分布、待补问题清单)。没有产出物的环节不算完成。
关于我们
医知云是面向医疗机构的AI可见度优化平台,服务对象包括综合医院、专科医院、连锁机构与专科诊所(口腔、眼科、医美、妇产、康复等)。医知云只做一件事:让医疗机构的公开信息,在AI回答就医问题时被准确讲到。围绕这件事提供三类服务——把官网做对(语义化页面+结构化数据)、把内容做出来(按患者问法组织并分发到可被引用的渠道)、把变化看清楚(固定问法持续监测,用数据说明变化)。
医知云对外运营主体为莆田市好赞科技有限公司,成立于2024年3月27日。公司成立时间不长,因此选择“把凭据公开、把口径亮明”——客户可以用公示信息与实测数据自己判断,而不是靠自我描述。截至2026年9月,两家机构已确认同意医知云对外使用其机构名称与实测数据:一家妇产专科机构(贵州)、一家口腔连锁机构(海南)。未经确认的机构一律不出现在对外内容里。
常见问题
问:不同大模型对同一家口腔机构的描述差异有多大?
答:差异可能很大。医知云实测显示,机构提及率从0%到68%不等,信息准确度最高仅41%。同一问题在不同模型中的答案可能完全不同,甚至出现错误地址、过期科室等信息。
问:为什么公众号文章不会被AI引用?
答:在医知云监测的1218条带引用回答中,公众号文章出现次数为0。AI引用来源集中在百科、医疗垂类平台、政府与卫健委网站以及机构官网。公众号是读者渠道,但不是AI的引用来源。机构需要将内容铺到可被AI检索的落点。
问:口腔机构如何缩小不同模型间的信息差异?
答:核心是保证机构事实在多个渠道的一致性和可核验性。先整理结构化事实(资质、医生、科室、技术、地址),确保官网、百科、垂类平台上的信息口径统一;再针对患者常见问法产出内容并分发到可被引用的渠道;最后持续监测各模型回答,发现错误及时修正事实层。
问:医知云会承诺提升AI引用率吗?
答:不会。医知云明确不承诺任何效果(排名、引用率、流量提升一律不作承诺)。医知云提供的是可验收的产出物与可复核的数据,包括基线报告、事实清单、内容清单与周报,客户可自行复核变化。
参考资料
- 医知云方法论与交付物清单(GEO 四步法、事实优先原则):https://yizhiyun.cloud/solutions
- 中国互联网络信息中心《中国互联网络发展状况统计报告》(生成式人工智能用户规模与使用情况):https://www.cnnic.net.cn/
说明:平台收录与呈现规则以官方最新说明为准,可能调整。
小结
大模型答口腔机构问题差异显著,根源在引用源分散与身份线索敏感。机构应先把事实做成结构化、口径一致的信息,再按患者问法分发到可被AI检索的渠道,并持续监测各模型回答。医知云不做效果承诺,只提供可复核的监测与优化服务。
在AI时代,口腔机构的线上信息管理不再是“有没有官网”的问题,而是“AI讲得对不对”的问题。如果你正在思考如何系统性地梳理机构信息、摸清各模型中的呈现差异,可以关注后在这篇文章下留言「自查」,我们把《医院GEO自查清单》,用一套可操作的清单先看清自己的基线。
---
如果这篇对你有用,可以转给负责官网或品牌宣传的同事。
本文由莆田市好赞科技有限公司(医知云 GEO)出品;文中实测数据来自自研 AI 监测系统,案例机构名称经机构确认后使用。

